15 сентября Cloudflare добавил настройку Disallow AI Training. Она закрывает контент от краулеров обучения моделей, но оставляет доступ Googlebot, Applebot и Bingbot. Важная деталь: по документации Google, токен, через который это работает, не управляет показом сайта в AI Overviews и AI Mode. Разбираем, что делает настройка и когда она нужна.
Что запустил Cloudflare
В анонсе Cloudflare настройка описана как новая опция в защите от ботов. Она доступна всем клиентам на всех тарифах и включается в Security Settings на уровне домена.
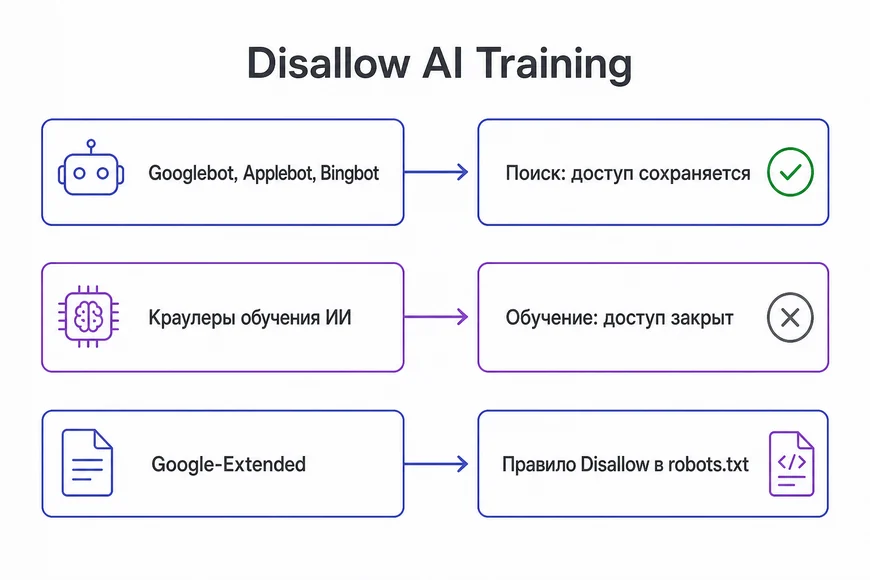
Идея в том, чтобы разделить два вида доступа. Поисковое сканирование остаётся, а сбор контента для обучения ИИ закрывается. Googlebot, Applebot и Bingbot продолжают ходить на сайт, поэтому индексация и позиции не страдают. Для Google это реализовано через правило Disallow для токена Google-Extended в robots.txt. По данным Search Engine Journal, новым доменам, которые зарабатывают на рекламе, эту настройку предлагают как пресет обучения по умолчанию.
Что Google-Extended закрывает, а что нет
Тут легко ошибиться, поэтому сверимся с документацией. В описании краулеров Google сказано, что Google-Extended не влияет ни на включение сайта в поиск, ни на ранжирование. Токен относится к Gemini: обучению будущих версий моделей и работе Gemini Apps и Vertex AI API. AI Overviews и AI Mode в этом перечне не названы.
Для них у Google есть отдельные механизмы. Страница «AI Features and Your Website» называет директивы nosnippet, data-nosnippet, max-snippet и noindex. Там же сказано, что для попадания в эти функции специальной разметки не нужно.
«Запретить обучение» и «не показываться в ИИ-ответах поиска» — две разные задачи, и настройка Cloudflare решает первую.
Нужно ли это включать
Это бизнес-решение, а не техническая необходимость, и ответ зависит от цели сайта.
- Есть платный или авторский контент, который вы не хотите отдавать на обучение моделей. Настройка удобна: один переключатель вместо ручной правки robots.txt.
- Цель — попасть в ИИ-ответы и упоминания. Полный запрет обучающих краулеров здесь надо взвешивать отдельно, эффект на видимость в разных системах мы не проверяли и утверждать ничего не будем.
- Сайт не на Cloudflare. Тот же запрет для Google делается строкой в robots.txt:
User-agent: Google-ExtendedиDisallow: /.
Что проверить после включения
- Откройте
/robots.txtсайта и убедитесь, что правило для Google-Extended добавилось, а Googlebot по-прежнему разрешён. - Проверьте в Search Console главную и пару типовых страниц через инструмент проверки URL: страницы должны быть доступны для сканирования.
- Понаблюдайте за индексацией и показами пару недель. Резкого изменения быть не должно, если правило добавлено корректно.
Как устроены robots.txt и другие директивы, мы разбирали в гайде про robots.txt, sitemap и noindex и в полном руководстве по robots.txt.
С чего начать
Определите, чего вы хотите от ИИ-систем: защиты контента или видимости в ответах. От этого зависит настройка. Если нужна помощь с robots.txt и проверкой доступности страниц для поисковых роботов, это входит в SEO-аудит, а как готовить материалы для цитирования нейросетями, описано в гайде по GEO.