
llms.txt — это текстовый файл в корне сайта в формате Markdown, в котором коротко описан сайт и перечислены ссылки на главные страницы для языковых моделей. Формат предложен в 2024 году и до сих пор остаётся предложением, а не стандартом. Google прямо пишет, что Поиск такие файлы не использует. Ниже разбор, что это за файл, кто его читает по первоисточникам, как его сделать и что для видимости в нейросетях важнее.
Что такое llms.txt
Формат описан на сайте llmstxt.org. Его автор — Джереми Ховард, предложение опубликовано 3 сентября 2024 года. Идея такая. Языковой модели трудно разобраться в обычном сайте с меню, рекламой и скриптами, а окно контекста у неё ограничено. Файл llms.txt даёт ей короткую выжимку о том, что это за сайт и где лежит главное.
Файл лежит по адресу /llms.txt в корне сайта или в подпапке, например /docs/llms.txt. Он написан в Markdown, поэтому его одинаково легко читать человеку и программе.
Как устроен файл
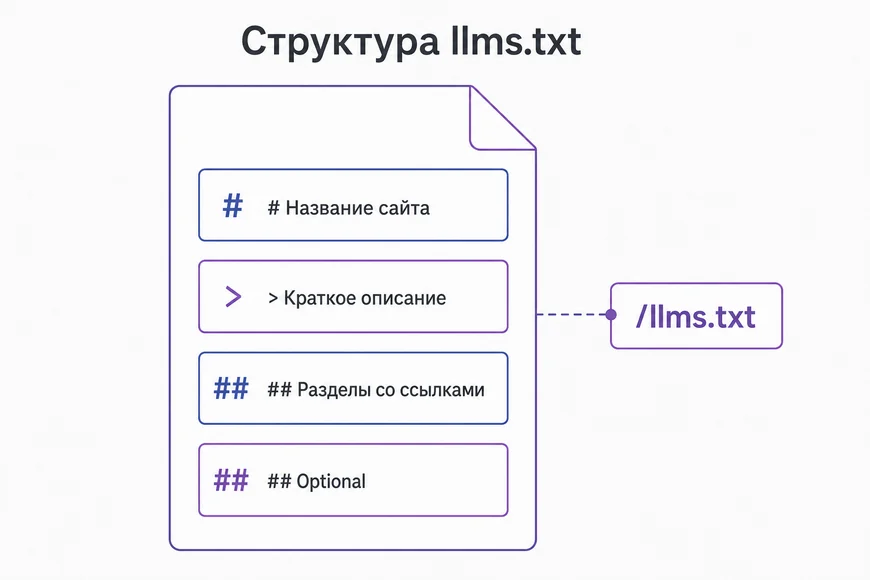
Порядок частей задан спецификацией.
- Заголовок H1 с названием сайта или проекта. Это единственная обязательная часть.
- Цитата с кратким описанием.
- Необязательные абзацы с подробностями, без заголовков.
- Разделы H2 со списками ссылок в формате
[название](адрес), после ссылки можно добавить пояснение. - Раздел «Optional» со второстепенными ссылками, которые модель может пропустить, если ей нужен короткий контекст.
Пример минимального файла.
# SEO Академия

> Продвижение и создание сайтов в Минске.

## Услуги
- [SEO-продвижение](https://seo-akademiya.by/uslugi/prodvizhenie-saytov/): цены и порядок работы
- [SEO-аудит](https://seo-akademiya.by/uslugi/seo-audit/): что проверяем

## Optional
- [Блог](https://seo-akademiya.by/blog/)
Спецификация предлагает и второе. Страницы, которые могут понадобиться модели, стоит отдавать в чистом Markdown по тому же адресу с добавкой .md. Иногда рядом кладут и llms-full.txt с полным текстом всех страниц, но в самой спецификации на llmstxt.org такой файл не описан.
Чем llms.txt отличается от robots.txt и sitemap
| Файл | Для кого | Что делает | Статус |
|---|---|---|---|
| robots.txt | Поисковые и другие роботы | Разрешает или запрещает сканирование | Стандарт, его соблюдают крупные поисковики и ИИ-компании |
| sitemap.xml | Поисковые роботы | Перечисляет страницы для сканирования | Стандарт, поддерживается Google и Яндексом |
| llms.txt | Языковые модели и ИИ-агенты | Кратко описывает сайт и главные страницы | Предложение, поддержка не подтверждена крупными поисковиками |
llms.txt ничего не разрешает и не запрещает.
Если вы хотите закрыть сайт от ботов нейросетей или открыть его, это делается в robots.txt, а не в llms.txt.
Кто читает llms.txt: что говорят первоисточники
Позиция Google записана в его руководстве по оптимизации для генеративного ИИ. Создание файлов LLMS.txt и другой «специальной» разметки Google относит к действиям, которые можно игнорировать. Для показа сайта в Google Поиске и ответах генеративного ИИ такие файлы не нужны, и эти данные в Google Поиске не используются.
Там же сказано, что поддерживать такие файлы для других сервисов можно. На видимость и позиции в Google это не повлияет, потому что Поиск их игнорирует. Уточнение добавлено 15 июня 2026 года, запись есть в журнале изменений документации Google.
Lighthouse
В инструменте Lighthouse от Chrome есть проверка llms.txt в группе аудитов для ИИ-агентов. Она отмечает страницу, только если при запросе файла сервер отдаёт ошибку. Если файла нет и сервер отвечает 404, проверка считается неприменимой, потому что файл пока необязателен.
Яндекс и нейросети
Официальной позиции Яндекса по llms.txt мы не нашли. OpenAI, Anthropic и Perplexity в своих документах о роботах описывают управление доступом через robots.txt, а не через llms.txt. Поэтому утверждения вида «ChatGPT читает ваш llms.txt и поэтому цитирует сайт» стоит проверять. Подтверждения от самих компаний мы не встречали.
При этом файл используют как удобный указатель для документации. Например, Anthropic публикует llms.txt для своей документации разработчика.
Нужен ли llms.txt вашему сайту
- Сайт бизнеса или блог. Файл не помешает, но и заметного эффекта ждать не стоит. Тратить на него больше получаса нет смысла.
- Документация, API, база знаний. Здесь файл полезнее: разработчики и ИИ-агенты действительно используют такие указатели, чтобы быстро найти нужный раздел.
- Если файл уже есть. Проверьте, что сервер отдаёт его без ошибки и в нём нет ссылок на закрытые от индекса и служебные страницы.
Отдельно остерегайтесь предложений «настроим llms.txt, и вы попадёте в ответы нейросетей». Google прямо относит такие файлы к тому, что можно игнорировать, а других подтверждений эффекта нет.
Как создать llms.txt
- Соберите главные страницы. Услуги, цены, контакты, лучшие материалы. Не больше двух-трёх десятков ссылок.
- Напишите описание. Одна-две фразы о том, кто вы и что делаете.
- Оформите в Markdown по структуре выше: H1, цитата, разделы H2 со ссылками.
- Положите файл в корень сайта, чтобы он открывался по адресу
/llms.txtс кодом 200 и типом text/plain. - Проверьте ссылки. Все должны отвечать 200 и вести на страницы, открытые для индексации.
На WordPress файл умеет создавать Yoast SEO, и у нас он сначала был именно таким. Когда мы проверили список, в нём оказались закрытые от индексации отчёты бесплатного аудита, всплывающие окна и их темы оформления, служебные разделы. Нейросетям это подавалось как главные страницы сайта.
В октябре 2026 года мы выключили генерацию в Yoast и положили в корень свой файл, составленный вручную. В нём описание студии и 40 ссылок на услуги, цены, контакты, лучшие статьи и карту сайта. Все страницы из списка отвечают 200 и открыты для индексации. Если файл у вас создаётся автоматически, посмотрите, какие страницы в него попали.
Боты нейросетей в robots.txt: пускать или нет
На присутствие сайта в ответах ИИ действительно влияет другое. Важно, какие боты могут читать сайт. У крупных компаний боты разделены по задачам, и это важно учитывать.
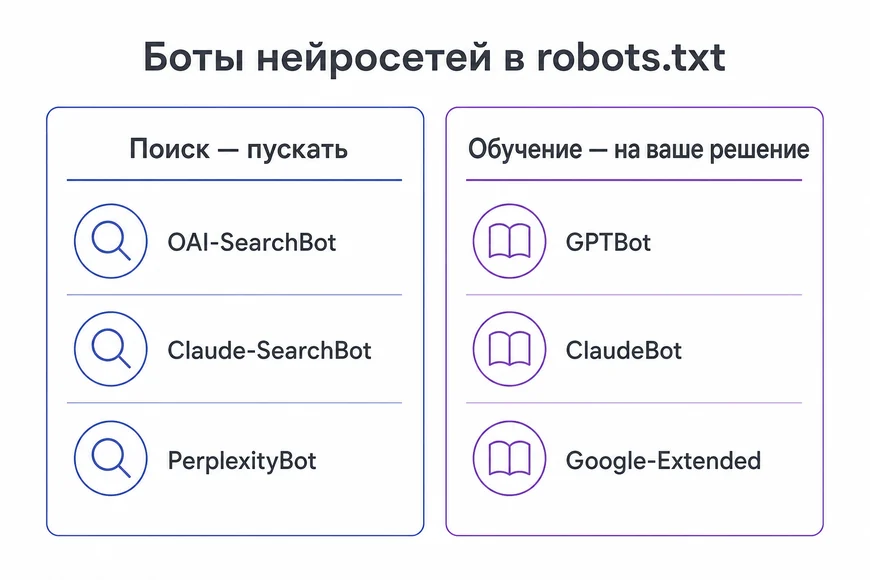
- OpenAI. По документации OpenAI, GPTBot собирает данные для обучения моделей, а OAI-SearchBot отвечает за показ сайтов в поиске ChatGPT. Запрет GPTBot не убирает сайт из поиска ChatGPT, за это отвечает OAI-SearchBot.
- Anthropic. По справке Anthropic, ClaudeBot собирает данные для обучения, Claude-SearchBot улучшает поисковые ответы, Claude-User загружает страницы по запросу пользователя. Компания соблюдает robots.txt.
- Perplexity. По документации Perplexity, PerplexityBot индексирует сайты для поиска и не используется для обучения моделей. Perplexity-User загружает страницы по запросу пользователя и, как правило, robots.txt не соблюдает.
- Google. Токен Google-Extended управляет тем, можно ли использовать контент для обучения Gemini. По документации Google, он никак не влияет на показ сайта в Google Поиске и не является фактором ранжирования.
Отсюда практический вывод.
Если вы хотите, чтобы нейросети цитировали сайт, не закрывайте поисковых ботов, то есть OAI-SearchBot, Claude-SearchBot и PerplexityBot. Боты для обучения можно закрыть, если не хотите отдавать контент в обучение, на поиск в этих сервисах это не влияет.
Что важнее llms.txt для видимости в нейросетях
Google в том же руководстве советует сосредоточиться на уникальном и качественном контенте, а не на специальных файлах. Для нейросетей работает то же, что для поиска. Это открытый для ботов сайт, понятная структура, ответы на вопросы в начале страниц, собственные данные и опыт. Подробно об этом — в гайде о том, как попасть в ответы нейросетей, а о качестве контента — в статье о качественном контенте.
Проверить, не закрыт ли сайт от нужных ботов и нет ли технических ошибок, поможет технический аудит. Мы делаем его в рамках услуги SEO-аудит, а работу над видимостью в поиске и нейросетях — в рамках продвижения сайтов.