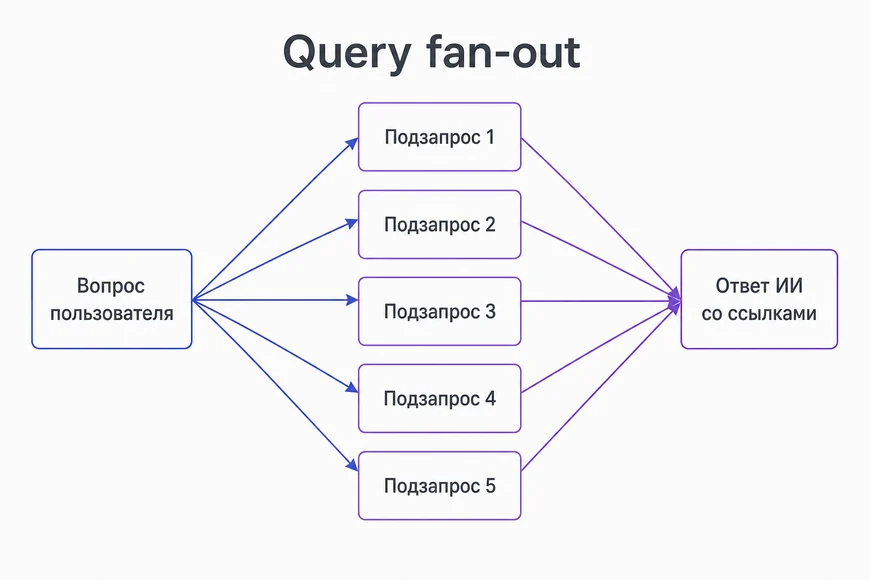
Query fan-out («веерные запросы») — метод, при котором ИИ-поиск разбивает вопрос пользователя на несколько связанных подзапросов, ищет по каждому и собирает ответ из найденного. Google использует его в обзорах от ИИ (AI Overviews) и режиме ИИ (AI Mode), ChatGPT — когда ищет в интернете. Для сайта это значит, что страница может попасть в ответ по смежной подтеме, а не только по точному запросу. Специальной оптимизации Google не требует, а помогают полное раскрытие темы, факты на странице текстом и данные, которых нет у других.
Что такое query fan-out
Обычный поиск отвечает на один запрос списком страниц. ИИ-поиск поступает иначе. Он сам формулирует несколько уточняющих запросов, отправляет их, читает найденное и пишет общий ответ со ссылками на источники.
Google описывает это в справке об ИИ-функциях Поиска. И краткий пересказ от ИИ, и режим ИИ при подготовке ответа могут использовать методику веерных запросов, когда разным источникам данных отправляется несколько связанных запросов по смежным темам. По словам Google, так удаётся показать более широкий и разнообразный набор полезных ссылок, чем в обычном поиске.
В записи о режиме ИИ от 20 мая 2025 года Google пишет, что система отправляет множество запросов одновременно от имени пользователя, а режим Deep Search может выполнить сотни поисков.
Как это выглядит на примере
Условный пример. Пользователь спрашивает «какой кондиционер выбрать для квартиры 60 м²». ИИ-поиск может разложить вопрос на подзапросы о мощности для такой площади, о разнице инверторных и обычных моделей, об уровне шума, о ценах и отзывах. Ответ собирается из страниц, найденных по каждому из них.
Страница магазина, где есть понятная таблица мощности по площади комнаты, может попасть в ответ, даже если по исходному запросу она не в топе.
Как веерные запросы делает ChatGPT
Самые подробные цифры есть у Ahrefs. В исследовании от 12 октября 2026 года разобраны 66,6 млн ответов бесплатной версии ChatGPT без входа в аккаунт за август и сентябрь и 15 млн веерных запросов к ним.
- Поиск в интернете запустили только 14,4% ответов. В остальных ChatGPT отвечал без поиска.
- Когда поиск был, на один ответ приходилось в среднем около 1,6 веерного запроса.
- 6,8% веерных запросов использовали оператор
site:, то есть ChatGPT искал на конкретном сайте. - Ссылки на Reddit упали примерно с каждого пятого ответа в марте до каждого 43-го в конце сентября, а на Википедию — с каждого седьмого до каждого 35-го.
Отдельно Ahrefs посчитал, какие слова ChatGPT добавляет к запросу пользователя.
| Что добавляется | Доля англоязычных веерных запросов | Что это значит для сайта |
|---|---|---|
| Год, «2026» | 22,9% в сентябре, 17,6% в августе | Нужна свежесть и дата обновления |
| «official» | 13,1% в сентябре, 10,1% в августе | ИИ ищет первоисточник, то есть сайт бренда |
| «price» | Относительный рост около 47% за месяц | Цены нужны на странице текстом |
| «reviews» | Рост примерно на треть за месяц | Нужны отзывы и сторонние обзоры |
Это данные по англоязычным запросам одной модели ChatGPT, поэтому переносить проценты на русскоязычный поиск напрямую нельзя, а логику можно.
Что это значит для сайта
Google прямо пишет, что для попадания в ИИ-функции не нужно соблюдать дополнительные требования, создавать специальные файлы или внедрять особую разметку. Работают обычные правила SEO. Но веерные запросы смещают акценты.
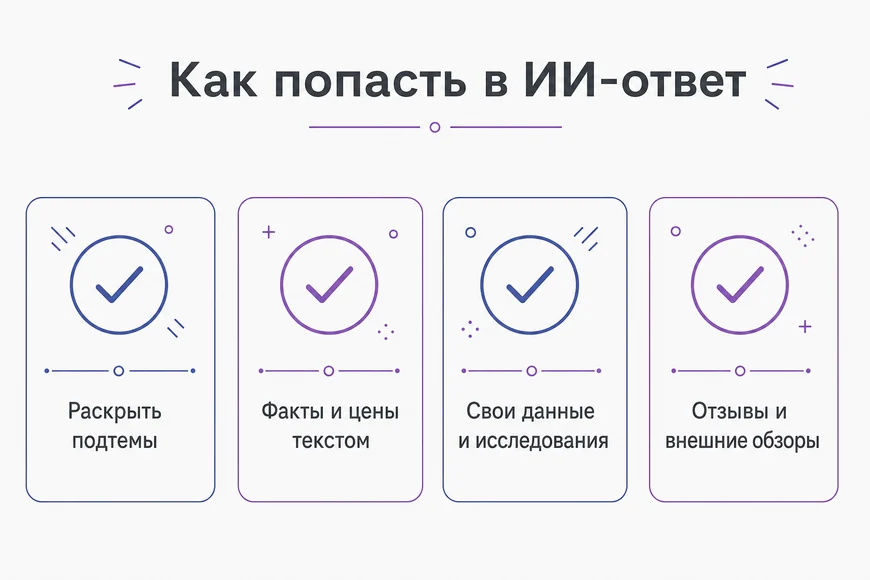
- Раскрывать подтемы. Ответ собирается по смежным вопросам, поэтому выигрывает страница, где разобраны все важные подтемы, а не только главный запрос. Блок частых вопросов здесь работает как готовый набор ответов на подзапросы.
- Писать факты текстом. Ahrefs советует публиковать цены, характеристики и условия поддержки обычным текстом на сайте бренда, на страницах, доступных роботам. ChatGPT часто ищет эти факты прямо на сайтах брендов.
- Давать своё. По тем же данным страницы, которые в основном пересказывают чужую работу, теряют цитирования, а выигрывают собственные исследования, тесты и данные о продуктах.
- Работать с внешними обзорами. На запросы со словами «лучший», «отзывы», «сравнение» одного сайта бренда может не хватить, нужны упоминания на сторонних площадках.
Как вообще устроено попадание в ИИ-ответы, разобрано в гайде о GEO.
Как найти подзапросы своей темы
Точные веерные запросы конкретного ответа видны только в отдельных исследовательских инструментах. Но подтемы, по которым их строит ИИ, можно собрать обычными способами.
- Подсказки Яндекса и Google по главному запросу.
- Блок «Похожие вопросы» в выдаче Google.
- Wordstat, особенно уточняющие фразы с «как», «сколько», «что лучше».
- Запросы в Search Console и Вебмастере, по которым страница уже получает показы.
- Сам ИИ-поиск. Задайте вопрос своей темы в ChatGPT или режиме ИИ Google и посмотрите, какие источники и подтемы попали в ответ.
Собранные подтемы распределяют по существующей странице и FAQ, а не по новым страницам. Как работать с запросами одной темы, разобрано в статье о типах поисковых запросов.
Чего делать не нужно
Самая частая ошибка — создать отдельную страницу под каждый возможный подзапрос. Получаются десятки похожих страниц, которые Google в правилах о спаме описывает как недопустимое масштабирование контента, когда много страниц создаётся ради позиций, а не ради пользы. Такие страницы ещё и плохо индексируются, подробнее — в статье о малоценных страницах.
Не нужны и специальные файлы. Google отдельно пишет, что для ИИ-функций они не требуются, это касается и llms.txt, о котором мы писали в статье о файле llms.txt.
Как проверить, попадает ли сайт в ИИ-ответы
С июня 2026 года в Search Console появляются отчёты об эффективности в генеративных ИИ-функциях, но пока не у всех сайтов. Если отчёта нет, остаётся ручная проверка. Задать ИИ-поиску вопросы своей темы и посмотреть, есть ли сайт среди источников. Как сделать это системно, по списку вопросов и с фиксацией результатов, разобрано в статье о GEO-аудите.
Если хотите понять, какие подтемы вашей ниши не раскрыты на сайте, начните с SEO-аудита. Тексты, которые отвечают на вопросы клиентов полностью, мы готовим в рамках контент-маркетинга.