
Дублированный контент — это одинаковый или очень похожий текст, который открывается по нескольким URL. Поисковая система сама выбирает из таких адресов один канонический и показывает его, а сигналы, например ссылки, рассеиваются между копиями. Главное решение — указать канонический адрес 301-редиректом, тегом rel=»canonical» или директивой Clean-param для Яндекса. Ниже причины дублирования, таблица «причина — решение» и как Google и Яндекс относятся к canonical.
В этой статье мы разберём основные причины появления дублей и, самое главное, предложим способы их устранения, которые описаны в документации Google и Яндекса.
Что такое дублированный контент
Дублированный контент — это идентичный или очень похожий текст, который полностью или частично повторяется на нескольких URL-адресах. Дубликаты бывают внутри одного сайта и на разных доменах, когда ваш оригинальный контент копируют другие. Поисковые системы, сталкиваясь с таким явлением, выбирают одну версию для показа, наиболее релевантную запросу. Google, если канонический URL не указан, сам определяет, какая версия больше подходит для результатов поиска. Яндекс объединяет такие страницы в группу дублей и выбирает одну из них. Выбранная поиском страница не всегда та, которую вы хотели бы видеть в выдаче.
Не путайте дублированный контент с каннибализацией. Дубли — это одна и та же страница по разным адресам, и лечатся они техническими средствами. Каннибализация — это разные страницы, которые борются за один запрос, и её решают правкой содержания. Обе проблемы подробно разобраны в статье о дублях страниц и каннибализации, а здесь речь о технической стороне и каноническом URL.
Простой пример из жизни
Представьте перекрёсток, где два указателя ведут в одно и то же место, но разными дорогами. Какую выбрать? Поисковая система оказывается в похожей ситуации. Она не хочет показывать пользователям два одинаковых результата, поэтому оставляет один, и не обязательно тот, который нужен вам.
Допустим, ваша статья про «ключевое слово x» доступна по адресу http://www.example.com/keyword-x/ и её же копия — по адресу http://www.example.com/article-category/keyword-x/. Такое часто случается в современных CMS. Затем одни блогеры ссылаются на первый URL, а другие — на второй. Что делать поисковой системе? Какой из адресов считать главным?
Многие думают, что проблема дублей касается только Google или Яндекса. Однако это заблуждение. Дублированный контент — ваша головная боль, из-за которой вы теряете трафик и клиентов. Если бы все ссылались на один URL, его авторитет и шансы попасть в топ были бы намного выше.
Почему важно бороться с дублированным контентом
Дублированный контент вредит рейтингу вашего сайта. Внешние ссылки и другие сигналы делятся между копиями, а не собираются на одном адресе, то есть дубли размывают ссылочный вес. Робот тратит время на сканирование одинаковых страниц, и для больших сайтов это означает потерю краулингового бюджета. А в выдаче может оказаться не та версия страницы, например с параметрами отслеживания в адресе.
Технические дубли внутри своего сайта — это не нарушение, а проблема настройки. Другое дело — сайты, которые массово копируют чужие материалы, и плагиат вместо уникального контента. В правилах Google в отношении спама отдельно описан скопированный контент, и за него можно получить меры вплоть до ручных.
Кроме того, дубли ухудшают пользовательский опыт. Посетители могут запутаться в похожих страницах и не найти нужную информацию. Забота о проблемах с дублирующимся контентом важна не только для роботов, но и для реальных людей — ваших потенциальных клиентов.
Основные причины дублирования контента
Существуют десятки причин появления дублей. Большинство из них носят технический характер. Вряд ли кто-то специально копирует свои же тексты в разные разделы. Скорее всего, это особенности работы CMS или настроек сервера.
Разработчики часто мыслят категориями базы данных. Для них статья одна, если у неё один ID в системе. Но для поисковика каждый URL — это отдельная единица контента. Отсюда и возникает путаница.
Непонимание концепции URL
Программист не сошёл с ума, он просто говорит на другом языке. В базе данных сайта статья действительно одна. Но CMS позволяет открыть её по нескольким адресам. Для разработчика уникален ID записи, а для Google — URL. Если объяснить это команде, они быстро поймут проблему и начнут её решать. Кстати, прочитав эту статью до конца, вы сможете сами предложить им варианты исправлений.
Идентификаторы сеанса (session ID)
Чтобы отслеживать действия посетителей и сохранять товары в корзине, сайту нужен «сеанс». Обычно для этого используют cookie. Но поисковые боты их не сохраняют. Некоторые сайты в таких случаях добавляют идентификатор сеанса прямо в URL. Каждая внутренняя ссылка получает уникальный параметр, создавая новый адрес и, соответственно, дублируя контент.
Параметры URL для отслеживания и сортировки
Параметры вроде ?source=rss или ?sort=price тоже порождают дубли. Для поисковика http://www.example.com/keyword-x/ и http://www.example.com/keyword-x/?source=rss — это разные URL. Первый помогает отслеживать источник трафика, но одновременно вредит ранжированию. Это касается любых параметров, не меняющих смысл страницы.
Парсеры и синдикация
Иногда другие сайты копируют ваш контент без спроса. Они могут не ставить ссылку на первоисточник, и поисковая система видит просто ещё одну копию статьи. К сожалению, с ростом популярности ресурса количество таких «пиратов» только увеличивается.
Чем популярнее ваш сайт, тем больше парсеров его копируют. С этой проблемой нужно и можно бороться!
Порядок параметров в URL
Некоторые CMS используют адреса вроде /?id=1&cat=2. При этом URL /?cat=2&id=1 ведёт на ту же страницу. Для пользователя разницы нет, но поисковая система считает это двумя разными документами.
Пагинация комментариев
В WordPress и других системах можно разбивать комментарии на страницы. Тогда у статьи кроме основного URL появляются версии с /comment-page-1/, /comment-page-2/ и так далее.
Текст статьи на них повторяется.
Страницы для печати
Раньше многие сайты создавали отдельные версии страниц для принтера. Если на них стоят ссылки, поисковики их находят и индексируют. Но какую версию вы хотите видеть в выдаче: полноценную страницу с навигацией и рекламой или голый текст? Очевидно, что первую. Поэтому от страниц для печати лучше отказаться.
WWW против без WWW, HTTP против HTTPS
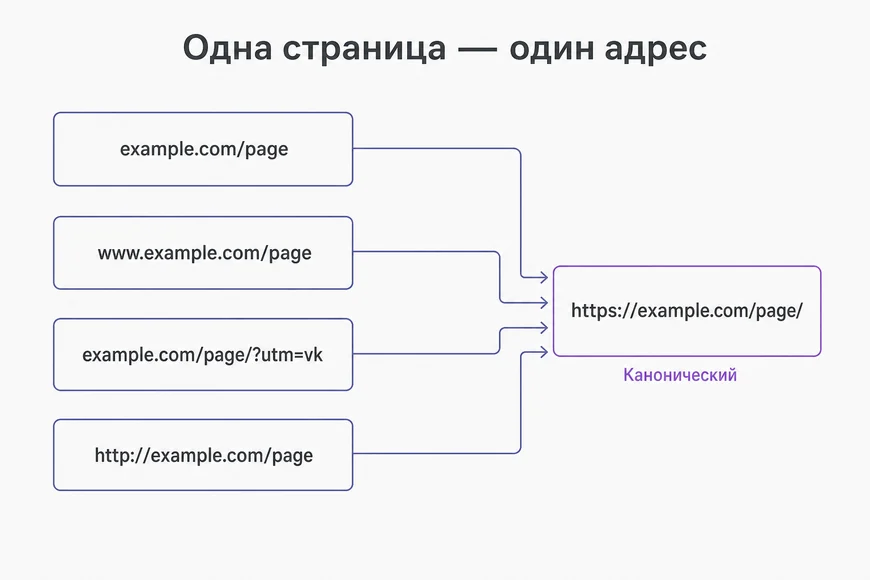
Иногда сайт открывается и с www, и без www. Или одновременно по HTTP и HTTPS. Это классические случаи дублирования, которые легко исправить правильной настройкой зеркал и редиректов.
Главное решение: канонический URL
Проблема дублированного контента решаема. Нужно выбрать правильный, «канонический» адрес для каждой страницы. Этот процесс называют канонизацией. Это тот URL, который вы хотите видеть в поиске и на который должны вести все ссылки.
Канонический URL — это эталон. Он указывает поисковику, какая версия страницы главная. Остальные адреса с тем же контентом должны либо перенаправлять на канон, либо ссылаться на него.
Как Google выбирает канонический адрес
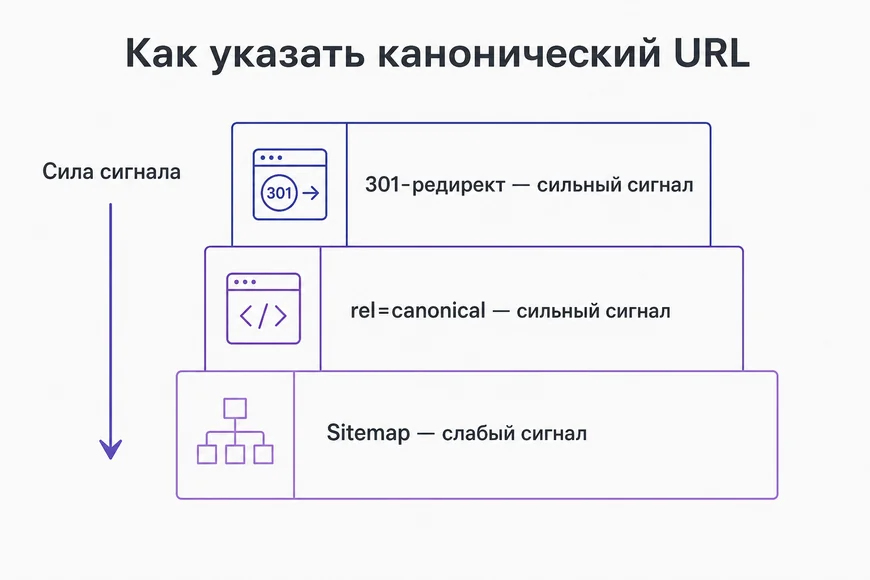
Google перечисляет способы указать канонический URL в порядке их эффективности.
- Переадресация. Явный признак того, что целевой адрес редиректа — канонический.
- Элемент rel=»canonical». Тоже явный признак, но страница-дубль при этом остаётся доступной.
- Файл Sitemap. Самый слабый сигнал, каноническими считаются адреса из карты сайта.
Способы можно сочетать, это повышает шанс, что Google выберет нужный адрес. Google не советует использовать для нормализации robots.txt, директиву noindex и инструмент удаления URL, а также указывать разными способами разные канонические адреса для одной страницы. При прочих равных он предпочитает HTTPS-версии страниц.
Как Яндекс относится к canonical
Яндекс в справке о дублировании страниц предлагает три инструмента. Для полных дублей — 301-редирект с одной страницы на другую. Если страницы отличаются только параметрами вроде UTM-меток, которые не влияют на содержание, помогает директива Clean-param в robots.txt. И указание канонического адреса через rel=»canonical», если изменить robots.txt нельзя. Для дублей со слешем и без слеша в конце адреса Яндекс canonical использовать не рекомендует, потому что в этом случае атрибут может игнорироваться.
User-agent: Yandex
Clean-param: utm_source&utm_medium&utm_campaign
Директиву Clean-param понимает только Яндекс. Для Google параметры решают через канонические теги на страницах с параметрами.
Причины дублей и решения: таблица
| Причина дубля | Пример адреса | Решение |
|---|---|---|
| Сайт доступен с www и без www | www.example.com и example.com | 301-редирект на основное зеркало |
| HTTP и HTTPS | http:// и https:// | 301-редирект на HTTPS |
| Слеш в конце адреса | /page и /page/ | 301-редирект на один вариант |
| Метки отслеживания | /page/?utm_source=vk | rel="canonical", Clean-param для Яндекса |
| Сортировка и фильтры | /catalog/?sort=price | rel="canonical" на основную страницу |
| Идентификатор сеанса | /page/?sid=123 | Сеанс в cookie, не в адресе |
| Статья в нескольких рубриках | /cat-1/post/ и /cat-2/post/ | Один постоянный адрес, редирект с остальных |
| Пагинация комментариев | /post/comment-page-2/ | Отключить разбивку или canonical на статью |
| Версия для печати | /post/print/ | CSS для печати вместо отдельной страницы |
Как найти дубли на своём сайте
Самый простой способ обнаружить проблему — воспользоваться поисковыми операторами Google. Например, чтобы найти все страницы сайта, содержащие определённую фразу, введите:
site:example.com intitle:"Ключевое слово X"
Google покажет все проиндексированные URL с этим ключевым словом. Чем точнее запрос, тем легче заметить повторы. Для поиска копий ваших статей по всему интернету используйте:
intitle:"Ключевое слово X – почему оно прекрасно"
Иногда стоит искать в кавычках целые предложения из текста, чтобы обнаружить дублированный контент на чужих сайтах. Парсеры могут менять заголовки, но содержимое часто копируют дословно. Если в выдаче Google появится сообщение о том, что часть похожих результатов скрыта, перейдите по ссылке и посмотрите, какие сайты копируют ваш контент.
Точнее всего дубли внутри сайта показывает отчёт об индексировании страниц в Search Console. Статус «Страница является копией. Канонический вариант не выбран пользователем» означает, что Google сам выбрал другой канонический адрес. Статус «Канонические версии страницы, выбранные Google и пользователем, не совпадают» означает, что ваш canonical проигнорирован, и стоит проверить, действительно ли страницы одинаковые. В Яндекс Вебмастере дубли видны среди исключённых страниц в разделе «Страницы в поиске». Для аудита сайта целиком подходят краулеры вроде Screaming Frog и инструмент проверки сайта в Semrush. Они находят страницы с дублированным текстом, одинаковыми title и H1, то есть повторяющийся контент.
Практические методы борьбы с дублированным контентом
Итак, вы определили канонические URL. Теперь нужно донести эту информацию до поисковых систем. Для этого есть несколько проверенных способов.
- Не создавать дубли изначально.
- Настроить 301-редирект с дубля на канон.
- Использовать тег
<link rel="canonical">на страницах-дублях. - Добавить на дублирующую страницу явную ссылку на оригинал.
Профилактика: избегайте дублирования
Многие причины дублей имеют простые решения. Проверьте свой сайт по чек-листу:
- Есть ли идентификаторы сеанса в URL? Их часто можно отключить в настройках CMS.
- Создаются ли отдельные страницы для печати? Откажитесь от них в пользу CSS-стилей для печати.
- Используется ли пагинация комментариев? Если комментариев немного, отключите разбивку в настройках.
- Параметры в URL могут идти в разном порядке? Попросите разработчика настроить «фабрику URL», чтобы параметры всегда следовали в единой последовательности.
- Есть ли проблемы с WWW и не-WWW или HTTP и HTTPS? Выберите основной вариант и настройте 301-редирект с альтернативного.
Если проблему не удаётся решить быстро, не откладывайте её в долгий ящик. Устранение дублей даст вашему сайту дополнительный импульс для роста трафика и привлечения клиентов. Подробнее о технических аспектах оптимизации читайте в нашем руководстве по внутренней оптимизации.
Настройка 301-редиректов
Иногда CMS упорно продолжает генерировать неправильные URL. В таком случае лучший выход — настроить 301-редирект с дублирующих адресов на канонический. Для Google это самый сильный сигнал канонической версии, а пользователь и робот сразу попадают на нужный адрес. О том, как правильно реализовать переадресацию, мы рассказывали в статье про 301-редиректы для SEO.
Канонический тег (rel=»canonical»)
Если удалить дублирующую страницу нельзя, но вы точно знаете, какой URL должен быть основным, используйте тег канонической ссылки. Он помещается в разделе <head> HTML-кода страницы-дубля:
<link rel="canonical" href="https://example.com/glavnaya-statya/" />В атрибуте href укажите полный канонический адрес. Это сильный сигнал, но не приказ. Google может выбрать другой адрес, а Яндекс игнорирует canonical для дублей со слешем и без.
Частые ошибки с каноническим тегом. Canonical ведёт на страницу с ошибкой 404 или с noindex. На странице два разных тега canonical. Указан относительный адрес вместо полного. С каждой страницы каталога canonical стоит на первую страницу, хотя Google в рекомендациях по разбивке на страницы просит давать каждой странице свой канонический адрес. Чтобы избежать типичных ошибок при работе с мета-тегами, изучите наше руководство по мета-тегам.
Ссылка на оригинал
Если вы не можете повлиять на код страницы (например, ваш контент скопировали на другом ресурсе), остаётся только просить о ссылке. Добавьте в RSS-ленту автоматическую ссылку на полную версию статьи. Некоторые парсеры её удалят, но не все. Если Google увидит несколько ссылок, указывающих на ваш сайт как на источник, он сможет определить оригинал. Кстати, о том, как защитить свои материалы, мы писали в материале про защиту контента от воровства.
Выводы: дублированный контент нужно и можно исправить
Дублированный контент встречается повсеместно. За годы работы мы не видели ни одного крупного сайта без единой проблемы с дублями. Это хроническая болезнь, за которой нужно следить постоянно. К счастью, современные методы диагностики и лечения позволяют эффективно с ней бороться. Устранив дубли, вы не только улучшите индексацию, но и повысите релевантность сайта в глазах поисковых систем. А это прямой путь к росту трафика и позиций. Если вам нужна помощь в SEO-продвижении, ознакомьтесь с нашими услугами по продвижению сайтов.