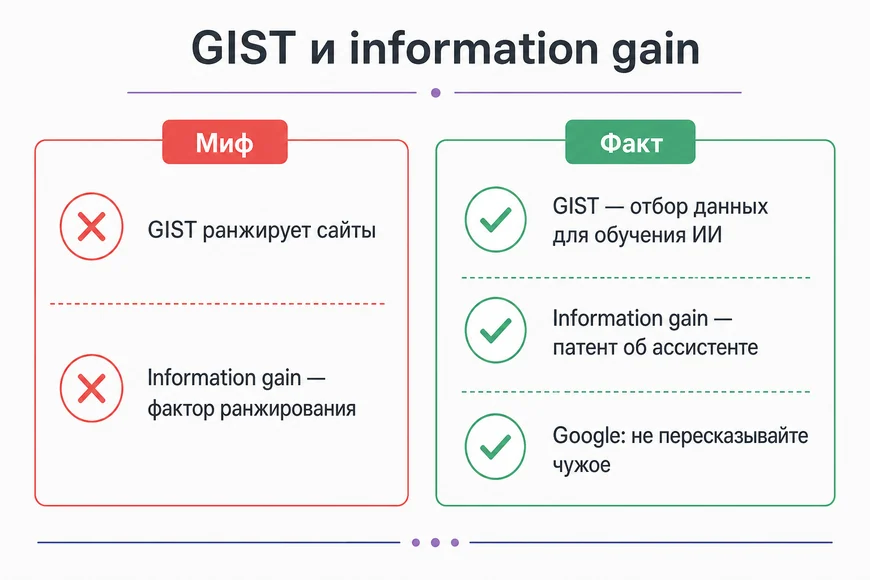
В SEO-видео и телеграм-каналах ходит объяснение, почему рерайт топа перестал ранжироваться: Google якобы запустил алгоритм GIST, который считает information gain, прирост информации, и понижает пересказы. Мы проверили по первоисточникам. GIST — метод Google Research для отбора обучающих данных нейросетей, о поиске в нём нет ни слова. Information gain — патент Google, в формуле которого речь идёт об автоматизированном ассистенте, и подтверждения, что он работает в ранжировании, мы не нашли. А вот вывод «пересказ чужих текстов проигрывает» верный. Его прямо пишет Google в официальной справке о полезном контенте.
Откуда взялся миф
Схема рассуждения простая.
Есть слово GIST, есть термин information gain, есть наблюдение, что тексты, собранные из статей топа, теряют позиции. Всё это склеивается в историю про новый алгоритм, который сравнивает вашу страницу с конкурентами и наказывает за отсутствие нового.
Каждую часть этой истории можно проверить по документам самого Google.
| Что говорят | Что в первоисточнике |
|---|---|
| GIST — алгоритм ранжирования Google | GIST — метод отбора обучающих данных для моделей машинного обучения, запись Google Research от 23 января 2026 года |
| Google считает information gain каждой страницы | Есть патент Google 2018 года, формула которого описывает автоматизированного ассистента |
| Это подтверждённый фактор ранжирования | Подтверждения от Google мы не нашли |
| Рерайт топа проигрывает | Верно, и это прямо написано в справке Google о полезном контенте |
Что такое GIST на самом деле
GIST расшифровывается как Greedy Independent Set Thresholding. Это метод из записи Google Research от 23 января 2026 года, авторы записи — Мортеза Задимогаддам и Мэттью Фарбах. По их словам, метод представили на конференции NeurIPS 2025.
Задача GIST — выбрать из большого набора данных небольшую часть для обучения модели так, чтобы данные были одновременно разнообразными и полезными. Опыты в записи проведены на классификации изображений, на наборе ImageNet. О поиске Google, веб-страницах, текстах и ранжировании сайтов в записи не сказано ничего.
Единственная связь с ранжированием — упоминание команды, которая отвечает за ранжирование на главной YouTube. Авторы пишут, что она использовала похожий принцип, чтобы сделать рекомендации видео разнообразнее. Это рекомендации YouTube, а не поиск Google, и это сходство принципа, а не сам GIST.
Что такое information gain
Термин пришёл из патента Google «Contextual estimation of link information gain». Его авторы — Виктор Карбуне и Педро Гоннет Андерс. Первый патент, US11354342B2, подан 18 октября 2018 года и выдан 7 июня 2022 года. Продолжение, US12013887B2, выдано 18 июня 2024 года.
Идея такая. Оценка прироста информации для документа показывает, сколько в нём новой информации сверх той, что пользователь уже видел в ранее просмотренных документах. Оценку может давать модель машинного обучения, а документы потом показываются с учётом того, сколько нового пользователь из них получит.
Важная деталь в формуле изобретения. Первый пункт описывает документы, информацию из которых пользователю уже показал автоматизированный ассистент в ответ на запрос, сформулированный обычным языком, и выбор следующего документа для этого ассистента. Поиск в описании тоже упоминается, но в описании первого патента выражение «automated assistant» встречается 67 раз, а «search engine» — 24.
Патент — не алгоритм
У Google много патентов, и наличие патента не означает, что метод работает в поиске. Заявлений Google о том, что information gain используется при ранжировании сайтов, мы не нашли. Поэтому статьи, где «формула information gain» расписана как работающий фактор, пересказывают предположение, а не факт.
Что Google говорит официально
Для вывода про рерайт патент и не нужен.
В справке о полезном контенте, обновлённой 7 октября 2026 года, Google предлагает авторам задать себе вопросы. Размещены ли на сайте оригинальные материалы, то есть факты, репортажи, исследования, аналитика. Содержит ли страница больше полезной информации, чем аналогичные материалы в результатах поиска. Если контент взят из других источников, переработан ли он так, чтобы представлять существенную ценность. А среди признаков контента, который стоит пересмотреть, прямо назван тот, где вы преимущественно пересказываете чужие материалы, ничего от себя не добавляя.
Это и есть та самая мысль, которую приписывают GIST. Только она не секретная и не новая.
Почему рерайт топа проигрывает
- Нечего показать сверх топа. Если страница собрана из десяти страниц выдачи, на вопрос Google «больше ли здесь полезной информации, чем у аналогов» ответ отрицательный.
- ИИ-ответы уже пересказывают топ. Обзор от ИИ или ChatGPT сам собирает ответ из нескольких источников, и пересказ пересказа читателю не нужен. Ahrefs в исследовании веерных запросов ChatGPT отмечает, что страницы, которые в основном пересказывают чужую работу, теряют цитирования. Подробнее — в статье о query fan-out.
- Одинаковые тексты не за что выбрать. Когда десять страниц говорят одно и то же, у поисковика нет причины показывать именно вашу.
Покрытие темы и новая информация — не одно и то же
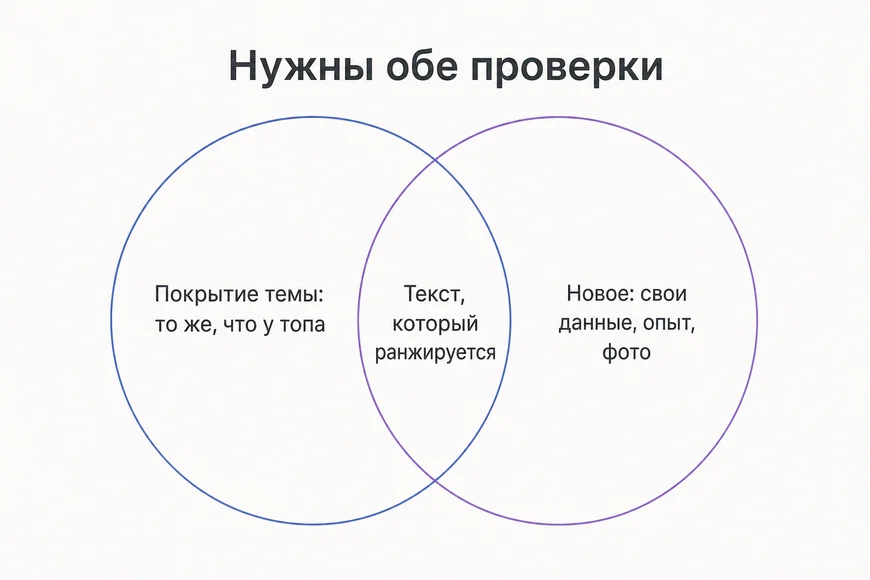
Сервисы вроде NeuronWriter считают, насколько текст покрывает термины топа. Это полезно, чтобы не пропустить важную подтему. Но высокая оценка покрытия значит только то, что вы сказали то же, что и конкуренты. Она ничего не говорит о том, есть ли у вас что-то своё.
Поэтому нужны обе проверки сразу.
Покрытие показывает, что тема раскрыта полностью, а собственные данные показывают, зачем читать именно вас. Как мы работаем с оценкой покрытия, рассказано в статье о NeuronWriter через API.
Как добавить в текст то, чего нет у конкурентов
- Свои цифры. Результаты кейсов, замеры, статистика из вашей CRM или аналитики, сроки и цены, если вы готовы их показывать.
- Свой опыт. Что пошло не так у вас или у клиента, какие ошибки встречаются на практике, чем отличается теория от реальной работы.
- Свои фото и примеры. Снимки работ, скриншоты, разборы конкретных страниц вместо стоковых картинок.
- Местная специфика. Законы, цены, сроки, поставщики и особенности рынка Беларуси, которых нет в российских и англоязычных статьях топа.
- Проверка по первоисточнику. Ссылка на документ, а не на пересказ. Как в этой статье, где каждое утверждение про GIST и патент сверено с записью Google и текстом патента.
- Мнение эксперта. Чёткая позиция по спорному вопросу с аргументами, а не «с одной стороны, с другой стороны».
Простая проверка перед публикацией. Выпишите, что в вашем тексте есть такого, чего нет ни на одной странице топа. Если список пустой, текст пока рерайт, каким бы уникальным он ни был по проверке на плагиат. Почему уникальность текста и уникальность смысла — разные вещи, разобрано в статье о проверке уникальности, а что вообще считать качественным контентом — в статье о качественном контенте.
Тексты с собственными данными и проверенными фактами мы готовим в рамках контент-маркетинга. Понять, какие страницы сайта сейчас пересказывают топ, поможет SEO-аудит.