11 сентября Яндекс выложил в открытый доступ базовую языковую модель, дообученная версия которой генерирует ИИ-ответы в Поиске. Формул ранжирования там нет, и переписывать сайт «под Алису» не нужно. Разбираем, что именно открыли, чего не открыли и какие выводы из этого действительно следуют для работы с сайтом.
Что именно открыли
Модель называется Alice AI Search Pretrain, обучена с нуля и выложена на Hugging Face. Пресс-служба формулирует так — компания первой выложила в открытый доступ базовую модель, дообученная версия которой генерирует ИИ-ответы в поиске.
Технические характеристики Яндекс разобрал отдельно.
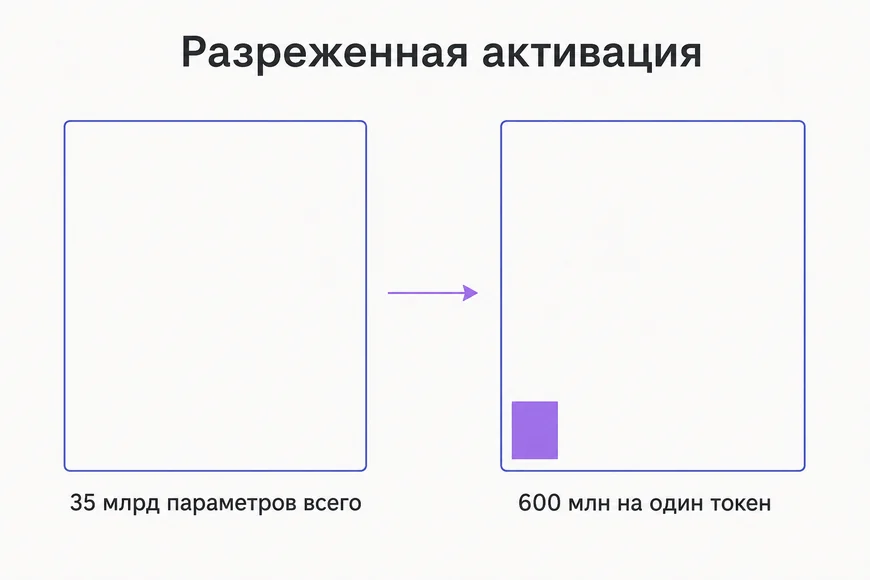
Архитектура гибридная: encoder-decoder с разреженной MoE. В модели 35 миллиардов параметров, но при обработке одного токена задействовано около 600 миллионов, то есть меньше двух процентов. Обучали её на 15 триллионах токенов собственного корпуса, а контекстное окно расширили с 8 до 128 тысяч токенов.
В Поиске, по сообщению пресс-службы, дообученная версия работает с июля. Быстрыми ответами ежемесячно пользуются более 49 миллионов человек.
Чего не открыли
Эту часть стоит проговорить отдельно, потому что заголовки про «раскрытую архитектуру» легко прочитать как раскрытие факторов ранжирования.
| Что стало доступно | Что осталось закрытым |
|---|---|
| Базовая модель и её архитектура | Формула ранжирования органической выдачи |
| Возможность изучать и запускать претрейн | Дообучение, на котором работает Поиск |
| Инференс через Hugging Face Transformers | Оптимизированный production-инференс, он только внутри Яндекса |
| Направление развития поиска | Критерии, по которым в ответ попадает конкретный источник |
| Общее устройство генерации ответа | Ретривал, антиспам и оценка качества документов |
Опубликован претрейн — заготовка. Поисковый контур вокруг него состоит из подбора документов, ранжирования, фильтров и оценки качества, и ничего из этого в открытый доступ не попало. Поэтому фразы вида «теперь понятно, как писать под Алису» к этой новости отношения не имеют.
Почему 600 миллионов вместо 35 миллиардов
Эта пара чисел выглядит технической деталью, но из неё следует вполне практический вывод.
Разреженная архитектура устроена так, что модель не прогоняет через себя все параметры на каждое слово. Она держит большой набор специализированных блоков и включает на каждый токен только малую их часть. В результате качество остаётся как у большой модели, а стоимость ответа — как у маленькой.
Дешёвый ответ означает частый ответ.
Пока генерация стоит дорого, её показывают выборочно и на узком круге запросов. Когда она дешевеет в разы, исчезает причина сдерживать показ, и блок появляется там, где раньше был обычный список ссылок. Аудитория в 49 миллионов человек в месяц — это следствие ровно такой оптимизации, а не рекламной кампании.
Планировать поэтому стоит не от вопроса «появится ли ИИ-ответ по моим запросам», а от вопроса «что будет, когда он там появится». Для информационных кластеров это уже реальность, для коммерческих — вопрос времени и экономики показа.
Почему это всё равно важно
Важна не сама модель, а то, что она подтверждает направление.
Поиск всё больше собирает ответ из документов, а не просто сортирует десять ссылок. Цифра в 49 миллионов человек ежемесячно — это уже не эксперимент на краю выдачи, а основной сценарий для большой доли аудитории. При таком масштабе позиция в тройке перестаёт автоматически означать клик.
Показательно, что то же самое происходит по другую сторону. Неделей раньше Google открыл всем сайтам отчёт о показах в генеративных функциях — мы разбирали это в выпуске новостей за 28 августа — 4 сентября. Две крупнейшие системы одновременно двигаются к тому, чтобы ответ формировался из источников, и обе начинают показывать это владельцам сайтов.
Что из этого следует на практике
Текст должен быть извлекаемым
Страницу проще использовать как источник, когда на ней есть прямой самодостаточный ответ, а не подводка на полторы тысячи знаков.
Практически это значит несколько простых вещей. Отвечать на запрос в первом экране, а не после вступления. Резать материал на смысловые блоки, каждый из которых закрывает один вопрос — что это, кому подходит, сколько стоит, какие ограничения, как выбрать. Следить, чтобы за каждым заголовком шёл абзац, который его действительно раскрывает, а не повторяет другими словами.
Доказательность важнее объёма
Тут полезно вспомнить, что Яндекс говорил о качестве контента раньше.
В блоге для вебмастеров ещё в марте 2025 года сообщалось, что точность определения низкокачественных документов, включая созданные с помощью ИИ, возросла до 99%. При этом там же сказано прямо: само по себе использование нейросетей негативным фактором не является, если материал качественный, проверен экспертом и не вводит пользователя в заблуждение.
Отсюда рабочий вывод. Ценность создаёт не способ производства текста, а то, что в нём есть помимо пересказа: собственные данные, ссылки на первоисточники, опыт, замеры, реальные цены и сроки, указанное авторство и дата обновления.
Метрики придётся расширить
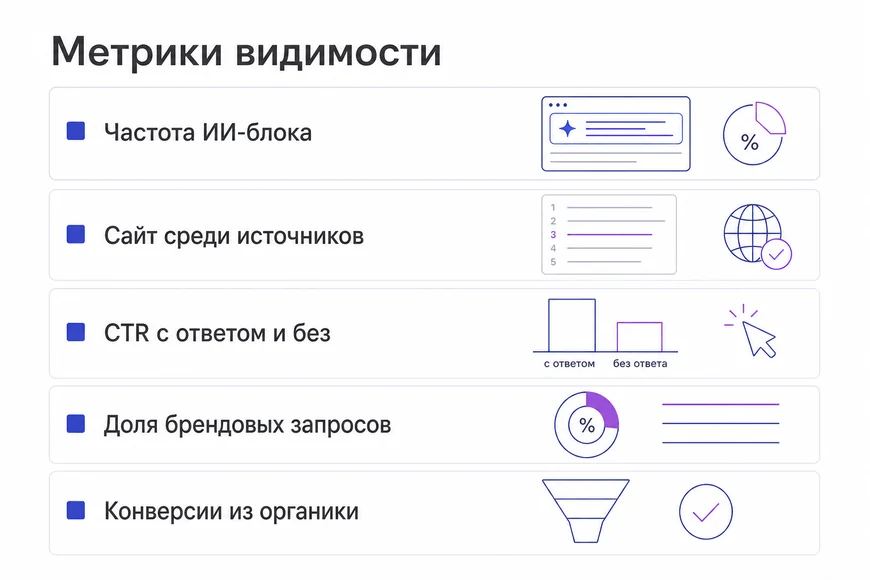
Если часть информационного интента закрывается прямо в выдаче, отчёт по одним позициям перестаёт описывать реальность.
- Наличие и частота ИИ-блока по кластерам запросов.
- Присутствие сайта среди источников ответа.
- CTR отдельно по запросам с генеративным ответом и без него.
- Доля брендовых запросов и прямых заходов.
- Конверсии из органики, а не только визиты.
Открытая модель не отвечает на вопрос «как попасть в ИИ-ответ». Она отвечает на другой — насколько всерьёз обе поисковые системы вкладываются в формат, где ответ собирается из документов. Планировать контент стоит исходя из этого, а не из попытки угадать веса.
Чего делать не нужно
Соблазн отреагировать масштабно возникает каждый раз после таких новостей, и каждый раз он обходится дорого.
- Массово переписывать тексты «под Алису». Критериев попадания в ответ никто не публиковал.
- Добавлять FAQ ради разметки. Блок вопросов без реальных вопросов читателя не помогает ни людям, ни поиску.
- Плодить посадочные страницы без собственной ценности — ровно то, что алгоритмы качества и отсеивают.
- Ориентироваться на детекторы ИИ-текста. Яндекс оценивает пользу материала, а не способ его написания.
План на ближайшие недели
- Собрать кластеры с риском. Отметить запросы, где в выдаче уже появляются быстрые ответы и другие блоки, забирающие клик.
- Проверить 20–50 ключевых URL. Отвечает ли страница на интент в первых абзацах, есть ли факты, авторство и дата обновления.
- Обновить коммерческие и вечнозелёные страницы. Добавить конкретику, сценарии выбора, ограничения, актуальные цены и сроки.
- Зафиксировать базу замера. Показы, CTR и позиции по интересующим кластерам сейчас, чтобы через квартал было с чем сравнить.
Практический разбор того, как оформить материал, чтобы его цитировали нейросети, у нас есть в отдельном гайде — GEO: как сделать, чтобы вас цитировали нейросети. Место этого направления среди остальных каналов привлечения трафика разобрано в материале про 25 каналов продвижения.
С чего начать
Начните с замера, а не с переписывания. Пока нет своих цифр по кластерам с генеративным ответом, любое решение о переработке контента принимается вслепую.
Для белорусских и российских проектов у этой новости есть отдельное значение. Яндекс здесь остаётся основной системой, и изменения в его выдаче доходят до бизнеса быстрее, чем изменения в Google. Если у вас большая информационная часть сайта, проверять её стоит начиная с этой недели, а не после того, как просядет трафик. Речь про блог, справочные разделы и страницы с ответами на типовые вопросы.
Разобрать, какие страницы отвечают на интент, а какие только подводят к нему, помогает SEO-аудит. Подготовку материалов, которые попадают в источники ответа и при этом продают, мы ведём в рамках контент-маркетинга.